Simplismart获1400万美元B轮融资:AI推理成本与延迟如何一起验收
Simplismart于10月27日披露1400万美元B轮融资,NVIDIA等参与。结合官方部署定价与NVIDIA指标文档,梳理AI应用团队如何同时评估推理成本、响应体验与运维条件。
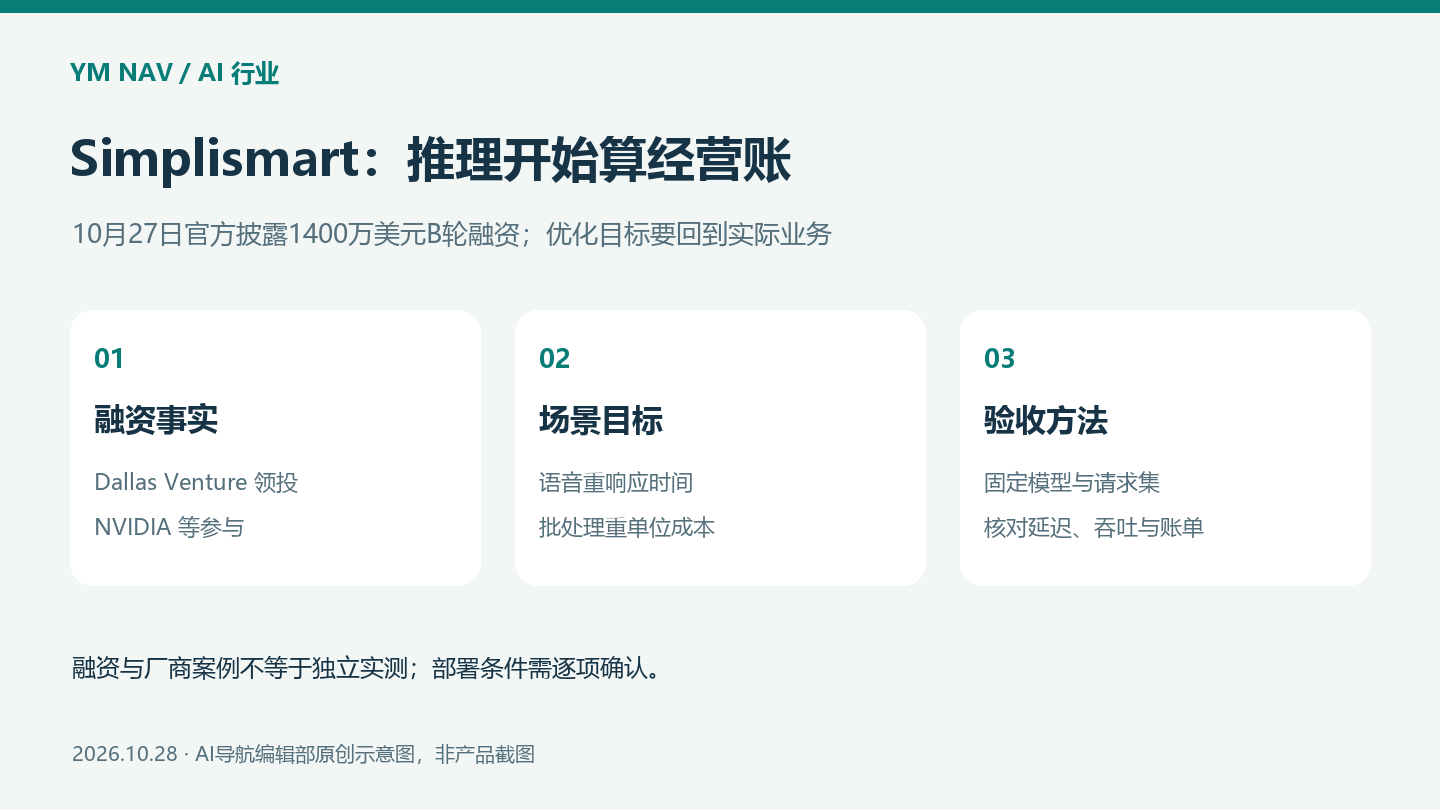
10月27日,AI推理基础设施公司Simplismart在官方博客披露1400万美元B轮融资,由Dallas Venture Capital领投,NVIDIA、Accel、Shastra VC和Micromax参与。比融资数字更值得应用团队研究的,是它提出的一个产品命题:推理系统需要同时满足业务成本、响应体验与部署位置的要求。融资消息证明的是公司宣布了新一轮资金支持,并不自动证明其方案适合所有工作负载。
新闻背景:优化对象从模型跑分扩展到业务约束
Simplismart将自己的服务定位于推理优化与部署编排,面向AI应用公司,也面向希望提供托管AI服务的云厂商。公告中的业务增长、客户案例和性能收益均来自公司自述,本站没有独立复现。因此本文不把个别案例的费用或延迟写成读者上线后可以获得的保证。
公开定价页展示了按量API、专用部署、BYOC及本地部署等路径。这表明比较对象不仅是每次调用的价格,还包括由谁管理算力、数据运行在哪里、空闲容量如何付费等问题。页面列价会变化,具体费用仍需以适用模型和当期合同核对。
影响:语音与离线任务需要不同的优化目标
以下为编辑部分析。语音助手即使最终回答正确,过长的等待也会破坏对话节奏;夜间处理文档的任务则可以用更长完成时间换取较低成本。若采购时只比较一个吞吐数字,就很难判断系统能否满足自己的业务。
NVIDIA的推理基准文档分别解释了首个token等待时间、完整请求延迟、token间延迟和吞吐。它们回答不同问题:用户何时开始看到内容、何时收到完整结果、生成是否持续顺畅,以及系统整体能完成多少输出。比较报告时,应先确认指标定义、输入输出长度和并发条件一致,再讨论谁更快。
如何把新闻变成一份可执行的验收方案
建议先选取真实但已脱敏的请求样本,固定模型版本、输出要求和质量门槛。把稳定流量与突发流量分别测试,记录失败请求和重试,并保留账单口径。只有在结果质量达到要求时,单位成功任务成本才有比较价值;若降低费用同时提高了返工率,名义单价可能掩盖总成本。
随后补充启动与扩容测试:模型是否已加载、流量突然增加时要等多久、低谷时期的最低费用是多少。对私有环境,还要确认平台支持的硬件与网络条件。融资公告里的“可部署”方向和项目现场的“可交付”结果之间,需要这些工程证据连接。
适合哪些人关注
准备把原型转为持续服务的创业团队,可以用它梳理推理账单;语音、视频及多模态应用负责人,可以按交互体验确定验收指标;云服务商和企业基础设施团队,可以进一步核对BYOC、专用部署的运维分工。普通个人用户若只需要偶尔调用AI,未必需要先承担复杂的基础设施管理工作。
当前判断与边界
本轮融资反映了生产推理这一环节获得资金支持。是否值得采用,仍应由真实流量下的质量、响应、总费用和运维负担共同决定。本文没有实测Simplismart,也不将官方案例当作通用性能承诺。
来源参考
资料核查截至北京时间2026年10月28日。以下为官方公告、治理资料、产品页面与技术文档;分析判断已与事实分开。