Phonic-1发布:语音AI开始边听边调用工具,企业该怎样验收
Phonic在10月29日推出Phonic-1并披露2750万美元融资。结合官方公告、开发文档与第三方评测方法,分析边听边调用工具的价值,以及语音智能体从演示进入业务流程时的验收重点。
背景:语音助手的竞争转向任务完成
Phonic 在2026年10月29日发布 Phonic-1,并宣布完成2750万美元 A 轮融资,由 First Round 领投。公告称,本轮后累计融资为3150万美元。本文关注的是这次产品发布背后的流程变化:语音系统如何把听懂一句话、调用业务系统和向用户确认结果接起来,而不是把融资规模当作技术效果的证明。
传统语音智能体常把语音识别、文字推理和语音合成串成一条链路。Phonic 将自身定位为直接处理语音输入并产生语音输出的模型公司。原生语音有机会保留语气、停顿等交互线索,但能否做好服务,仍取决于业务工具和错误处理。
发布了什么:把工具调用放进对话过程
官方公告与开发文档共同强调,Phonic-1 可以在来电者仍在说话时调用工具,而不是等一句话完全结束,再开始查询。文档列出了 API、Python 和 TypeScript SDK、命令行以及无代码构建方式,并给出 phonic-1 模型标识;这说明产品面向的是需要接入现有流程的开发者与运营团队。
公告还称模型支持50多种语言及对话中切换语言。上述范围来自厂商资料,不能直接推导为所有中文口音、行业术语和电话线路都已验证。本站没有进行语音实测,也没有依据演示给出“替代人工”的判断。
怎样理解评测:排行榜与真实业务各回答一部分问题
Phonic 在发布公告中称,其模型在当时的 Artificial Analysis Speech to Speech Index 位居首位。这是带有2026年10月29日时间标记的厂商陈述,排名会随候选模型和方法更新变化。本站引用第三方方法页解释评测口径,不把发布时名次写成长期保证。
Artificial Analysis 的方法页将语音推理、智能体表现、竞技场偏好和任务成功率合成为指数,并分别介绍对话停顿、轮次切换与打断等测试。对业务团队而言,这些维度有助于拆问题,但综合分数不能直接替代自己场景中的测试。还要核对评测是否覆盖真实工具、长通话、失败重试和人工转接。
影响:提前查询有价值,提前写入需要明确条件
以预约服务为例,用户还在描述时间与地点时,系统可以先读取空位;确认日期、人数和身份后,再提交预约。这是本站提出的应用设计示例,并非对 Phonic 客户部署情况的陈述。它把“什么时候开始计算”与“什么时候允许改动业务数据”分开处理。
读数据的失败通常可以重试,改订单或提交请求则需要避免重复执行。采用这类语音模型的团队,可以为每个工具设置参数校验、确认环节和唯一请求标识,并在工具返回失败时如实告知。仅让回复变快,无法保证业务最终状态正确。
适合哪些人关注:有明确通话流程的团队
客服系统开发者、预约与调度平台、招聘流程产品及语音交互研究人员,适合关注这种边听边执行的架构。对于已经有成熟转写链路的团队,评估重点应是端到端业务收益:流程是否缩短、打断是否减少、人工接管是否更顺畅。
如果只是播报固定内容,或现有业务接口尚不可靠,换一个原生语音模型未必能解决主要瓶颈。先整理工具输入、错误返回与用户确认规则,通常更容易看清试点是否值得扩大。
落地建议:用同一批任务做对照验收
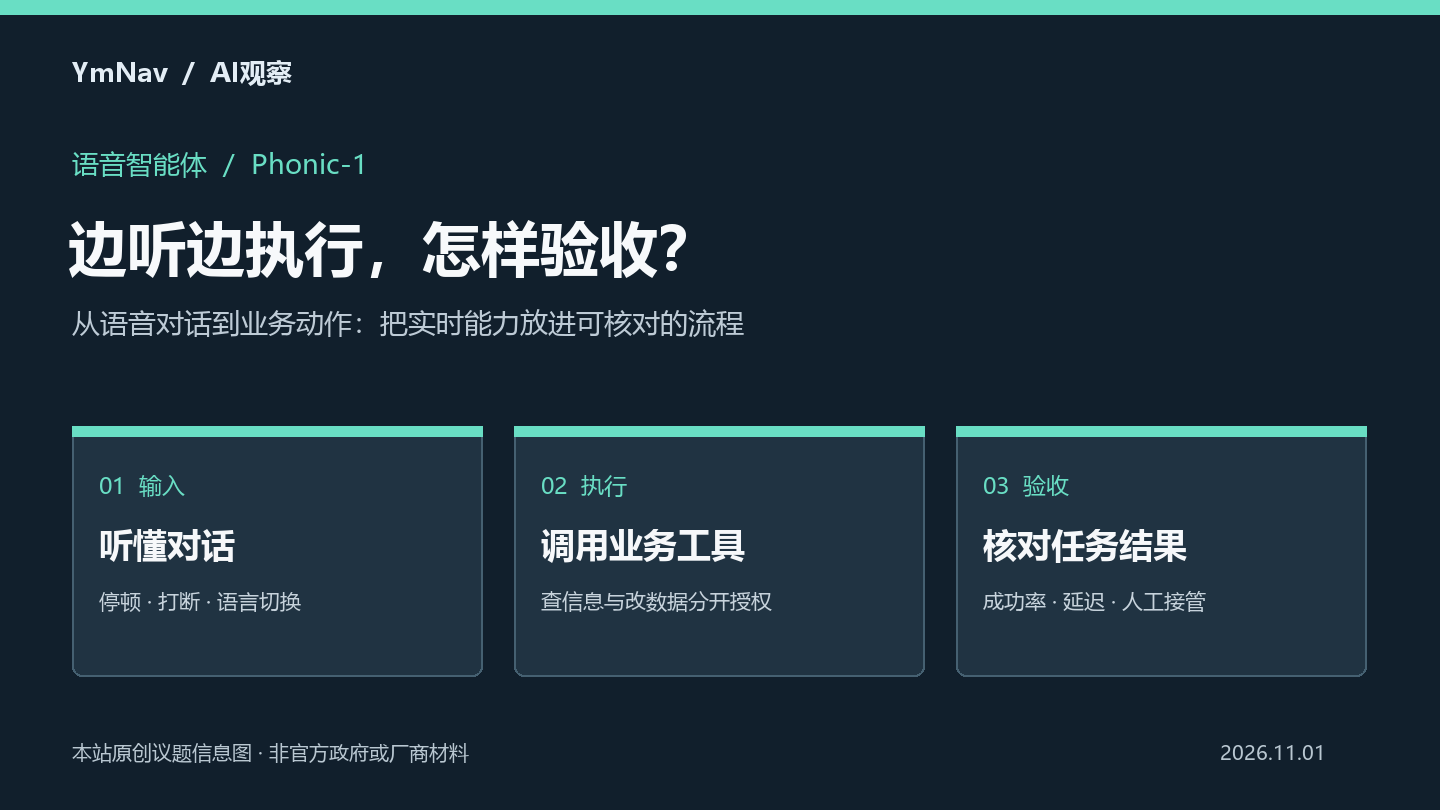
本站建议选取一组可复现的任务,覆盖噪声、沉默、临时改口、连续查询及工具超时;同时比较原有系统与新方案。记录任务成功率、首段语音延迟、完整通话耗时、错误动作和转人工比例,避免只挑一段顺畅演示。
计费也应按完成一次有效服务的总成本比较,将失败重试、工具调用和接管成本一并纳入。原生语音的意义,是给实时交互增加一种可选路径;产品是否合格,仍要由真实流程中的可核对结果来判断。
来源参考与核验说明
资料核对日期:2026年11月1日。以下链接供读者追溯事实;分析与建议由本站独立整理。