腾讯混元 Hyra 2.0 转向自动科研:AI 智能体开始沉淀可复用成果
腾讯混元 11 月 2 日更新 Hyra 研究智能体与公开成果仓库,新增蛋白质模型和分子力场等代码、权重与技术材料。本文区分发布方报告与独立验证,分析科研 Agent 从解题走向可复用工具的意义。
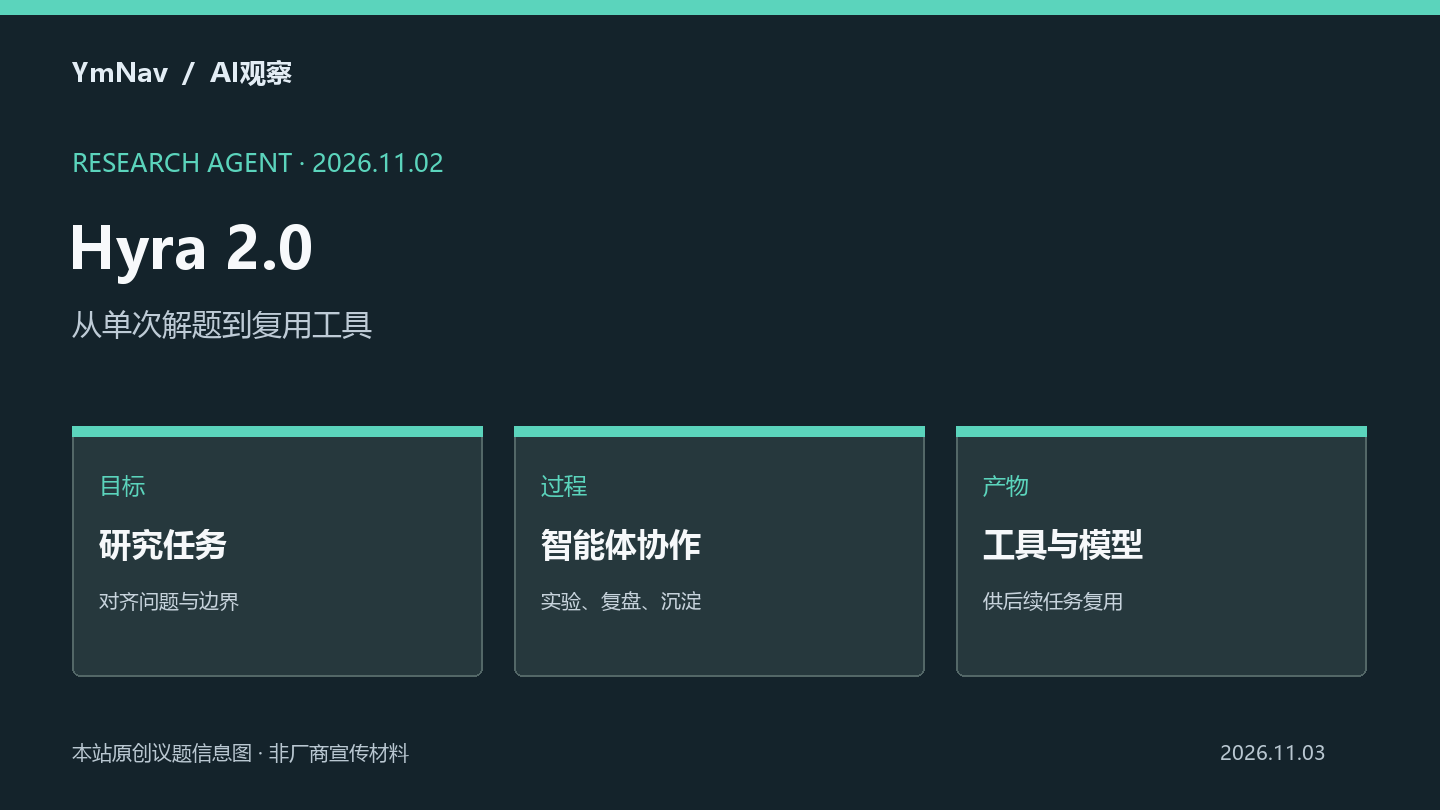
腾讯混元在 2026 年 11 月 2 日更新 Hyra 研究智能体相关内容,将方向概括为从“解决问题”走向构建可复用的工具、模型与工作流。比起再多一个聊天入口,这次值得留意的是:研究过程的产物开始以代码、权重和技术说明的形式公开,外部研究者可以逐项检查和复用。
需要先划清边界:这些材料证明的是发布方公开了若干研究产物,并不自动等于每项科学结论已被独立复现,也不说明通用用户现在就能直接使用一个完整的自动科研服务。
这次更新是什么
腾讯混元的研究页介绍 Hyra 作为 Hunyuan Research Agent;配套的 Tencent-Hunyuan/hyra-results 仓库则收集其在科学、数学、工程和创意方向的结果,以及部分可复现脚本。仓库在 11 月 2 日列出的更新包括两个蛋白质模型 HyInv 与 HyPLM-Flash,以及 HyFF 分子机器学习力场;页面注明相关代码、权重和技术报告已放入对应目录。
这类更新的重点不是模型名称本身,而是交付边界变得更具体:结果、运行代码、权重和报告能否一起拿到,问题定义和基线是否写清楚,外部团队能否在不同环境中复跑。它们决定研究 Agent 的产出能否成为下一个实验的起点。
背景:科研 Agent 不只要“答对一次”
常见生成式 AI 以一次问答或一次代码生成为单位;科研工作则包含文献查找、假设形成、实验或计算、错误诊断、结果记录与复核。单次给出看似合理的结论,并不能替代这一整条链路。自动化系统若能把失败原因、可执行脚本和中间决策一起保存,就有机会降低重复劳动。
Hyra 2.0 对外表达的变化,可以理解为把“研究者 Agent”从任务执行器延伸为工具构建者。这个定位仍需按具体项目判断:科学问题是否定义清楚,输出是否有可检验的评价标准,数据与依赖是否足以复现,都是比演示视频更重要的检查项。
影响:可复用性比单个漂亮结果更关键
对科研团队来说,公开代码和模型有望缩短从想法到基线实验的准备时间;对 AI 开发者来说,成果仓库提供了观察 Agent 如何组织领域工具和工作流的材料;对评测者来说,它也让“自动科研”可以从抽象愿景转向逐项审计。
但仓库中的发布说明和性能比较仍属于发布方提供的信息。不同任务的基线、数据切分、硬件、误差指标和复现成本会影响结论,不能把某个任务上的结果外推成“AI 已能自主做科研”。复用代码也不意味着没有许可、计算资源、数据治理或领域专家审核要求。
适合哪些人关注
AI for Science 研究者可以关注具体目录中的数据、脚本、权重和技术报告是否足够支撑复现;模型平台与 Agent 工程团队可以观察工具调用、状态管理和研究记忆如何沉淀;高校和企业实验室负责人则适合把它作为工作流设计案例,而不是未经评估就交付给研究人员的替代方案。
如果要试用或复现,建议先选一个目标明确、结果可自动判定的小任务,记录人工基线、Agent 调用成本、失败率和复跑一致性,再讨论是否扩大范围。对药物、材料等高影响领域,模型建议仍应由相应专业人员审查。
来源参考
- 腾讯混元研究页:Hyra / Hunyuan Research Agent
- Tencent-Hunyuan 官方 GitHub:Hyra-results 成果、更新记录与许可
- AREX Research:Hyra 2.0 更新报道与来源汇总,2026 年 11 月 2 日
本文依据腾讯混元研究页、官方成果仓库与独立报道交叉整理。文中所述模型与成果由发布方提供,未将其表述为独立复现结果;许可和使用条件以各具体目录中的文件为准。


