Vercel网关报告:Jev触达35%付费团队,支出仅占0.27%
Vercel十月报告显示,Jev上线前两周触达约35%的网关付费团队,但仅占同期估算支出的0.27%。结合TypeSafe文档,拆解决策模型的工作流价值与统计边界。
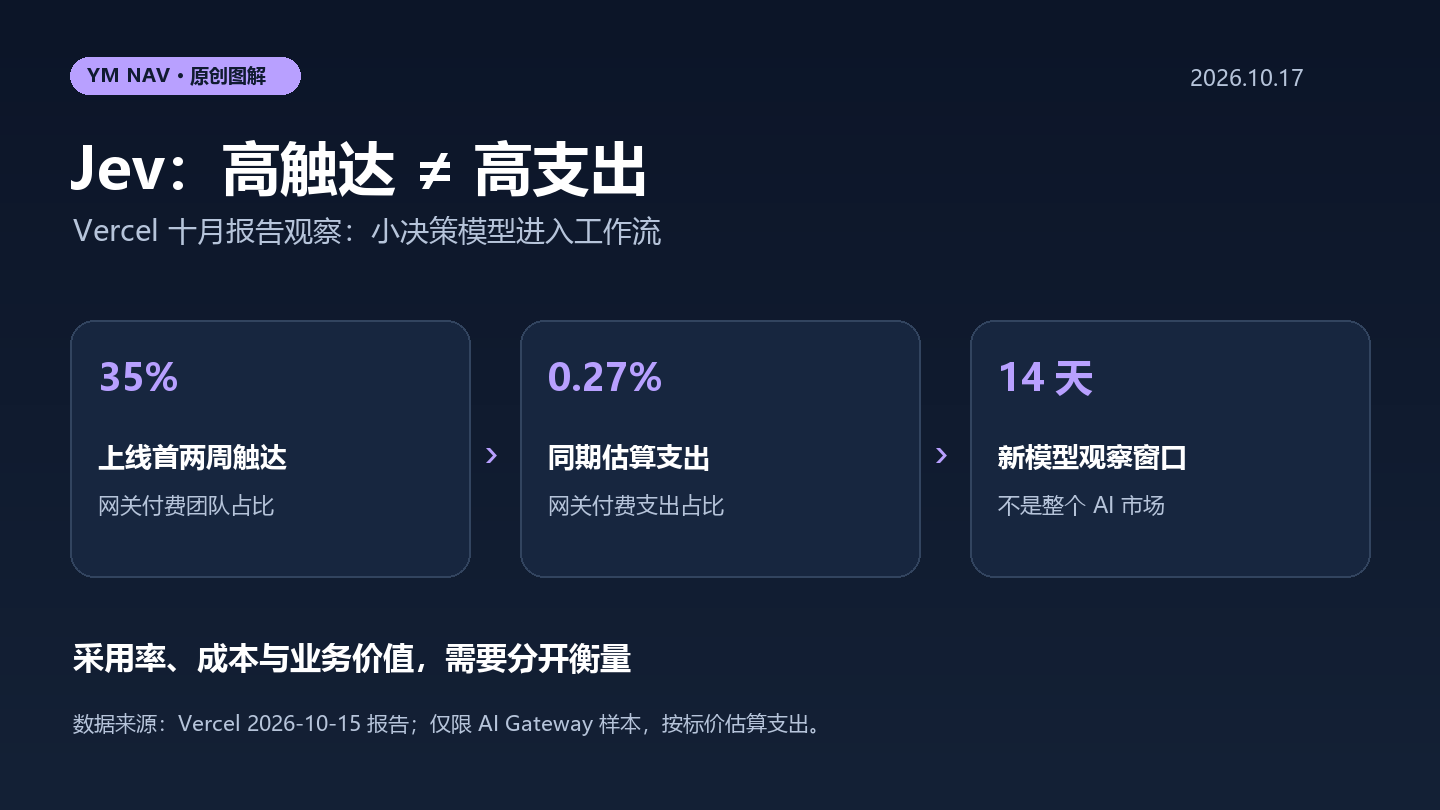
2026年10月15日,Vercel 发布十月 AI Gateway Production Index;这份主要观察截至9月网关流量的报告,给出了一个很有启发性的反差:Jev 在上线前两周触达约35%的网关付费团队,却只占同期网关估算支出的0.27%。
这不是“Jev拿下35%的全球AI市场”,也不意味着它贡献了相应比例的业务价值。结合 TypeSafe 的产品文档与版本局限说明,更合理的解读是:一种只负责短小、结构化判断的模型,可能以很低的支出权重嵌入许多应用。
先读清口径:触达率和支出占比不是同一件事
报告的新模型指标观察的是各模型上线后的前14天,样本来自外部付费团队。触达率的分母,是发布月份开始至数据截止期间活跃的付费团队;支出占比的分母,则是相应观察窗口内的网关付费总支出。两者回答的问题不同,不能相除后直接当作单个客户的使用强度或投资回报。
此外,Vercel 使用匿名聚合的 AI Gateway 流量,支出按公开标价估算,实际账单可能不同。因此,这组数据适合观察一个网关中的采用结构,不能外推整个模型市场、企业实际采购额或中国用户渗透率。“采用最快”也是报告所述的网关历史口径,而不是全行业排名。
Jev是什么:让模型回答选择题,让代码接管流程
TypeSafe 将 Jev 定位为 System One 决策模型:应用提供状态与明确的问题,获得可由代码直接使用的结构化结果,而非先生成一段自然语言再解析。官方文档介绍的基本问题类型包括选项选择、按规则评分,以及对陈述作真假程度判断。
一个原创的应用示例是客服入口分流:系统先提供当前工单与必要上下文,让模型在“退款咨询、技术故障、人工复核”中作选择;程序再依据结果调用已有流程。这里的模型不是替代全部客服工作,而是提供一个边界清楚的判断。退款金额计算、账户权限与真正的支付动作,仍应由确定性代码和授权机制负责。
为什么值得关注:一个主模型之外,可能还有许多小判断
当应用只需判断“走哪条流程”“这段资料是否相关”“是否值得升级给更强模型”时,长篇生成可能不是必要步骤。决策模型的价值假设,是把这些重复、短小的问题做成可组合接口,让生成模型集中处理确实需要解释或创作的任务。
这也解释了为什么高触达不必对应高支出:同一个团队可以在多个流程尝试轻量判断,同时仍把主要预算用于复杂生成或长任务。但这是对数据与产品机制的分析,报告本身并未证明具体团队已经靠 Jev 降本,也没有证明它能替代所有分类器或通用大模型。
不要把置信度当安全许可
TypeSafe 文档提供了利用置信度控制流程的设计思路。实际落地时,可以把低把握的样本交给人工或其他模型,但阈值需要结合自己的误判成本与验证集确定。一个返回结构正确、看起来把握很高的答案,仍可能在新领域出错,更不能自动获得转账、删库或访问私人数据的权限。
厂商公开的 jev-1.13 局限说明,还提醒用户留意字面理解、精确数字处理、日期比较、间接指代与无关上下文等问题。这些说明针对特定版本,不能套用成所有后续模型的固定结论;但它提示了通用的工程原则:能由程序精确完成的计算与校验,不必交给模型猜测。
适合哪些人关注:把“试过”变成“可衡量”
- Agent与SaaS开发者:从意图路由、资料筛选等低风险环节试点,保留人工兜底,不直接承接不可逆动作。
- AI平台负责人:分别追踪触达团队数、重复使用、每次成功判断成本与误判率,避免用调用量替代业务效果。
- 产品经理:先定义可接受的错误与升级条件,再选择模型;必要时与规则引擎、传统分类器和现有大模型公平对照。
与融资新闻不同,本次更新值得观察的是生产使用结构:一个模型可以被很多团队尝试,却只拿走很少预算。下一步更有价值的证据,是持续留存、真实任务准确性和完整工作流成本,而不是把一项网关采用指标包装成市场份额。
来源参考与核验说明
- Vercel:AI Gateway Production Index — October 2026(2026-10-15)
- TypeSafe:Introduction(Jev与结构化决策)
- TypeSafe:Confidence(置信度定义与使用)
- TypeSafe:Confidence-gated routing(流程设计模式)
- TypeSafe:Jev 1.13 jaggedness(2026-10-02复核的特定版本局限)
核验时间:2026年10月17日。数据仅代表Vercel所述网关样本,非本站独立市场调查;产品机制与局限来自TypeSafe文档。本文的客服分流为解释性示例,并非对外宣称的客户案例,亦未复述此前融资主题。


