DeepSeek开源DeepInfer:推理框架走向透明,完整在线服务仍需补齐哪些环节
DeepSeek公开面向大规模推理的DeepInfer,支持NVIDIA SM100和华为昇腾950。结合部署问答、评测脚本与开源生态文档,梳理框架开放内容、硬件门槛和在线服务仍缺少的组件。
2026年10月20日,DeepSeek开源推理框架DeepInfer的消息进入开发者视野。截至10月21日,官方仓库、部署问答和评测说明已可查阅。与此前受到关注的V4.1 Flash模型更新相比,这次值得讨论的是模型背后的运行系统:当用户量和上下文长度同时增长,团队怎样把模型能力稳定、可控地交付给真实业务?
本文综合DeepInfer仓库、部署问答、评测指南及vLLM官方文档独立梳理。框架能力、内部系统设计目标和编辑分析分别表述;没有把厂商内部服务指标当作第三方可复现的部署承诺。
开放了什么:离线推理核心与分布式执行能力
官方将DeepInfer定位为支撑DeepSeek大规模生产服务的高性能推理框架。本次开源版本提供离线推理,当前列出的支持模型是DeepSeek-V4.1-Flash,代码采用Apache 2.0许可证。README还明确给出支持硬件:NVIDIA SM100 GPU与华为昇腾950 NPU。这里的硬件名单不能延伸理解为任意消费级显卡或所有昇腾型号都能直接运行。
框架覆盖优化算子、模型执行、采样与并行调度,也支持结构化输出。对应用开发者来说,限制输出符合JSON Schema等格式,能够减少模型结果接入后续系统时的解析负担;对基础设施团队来说,计算、通信和调度如何配合,才是吞吐与响应时间的主要工程问题。
为什么开源框架不等于一套可直接上线的云服务
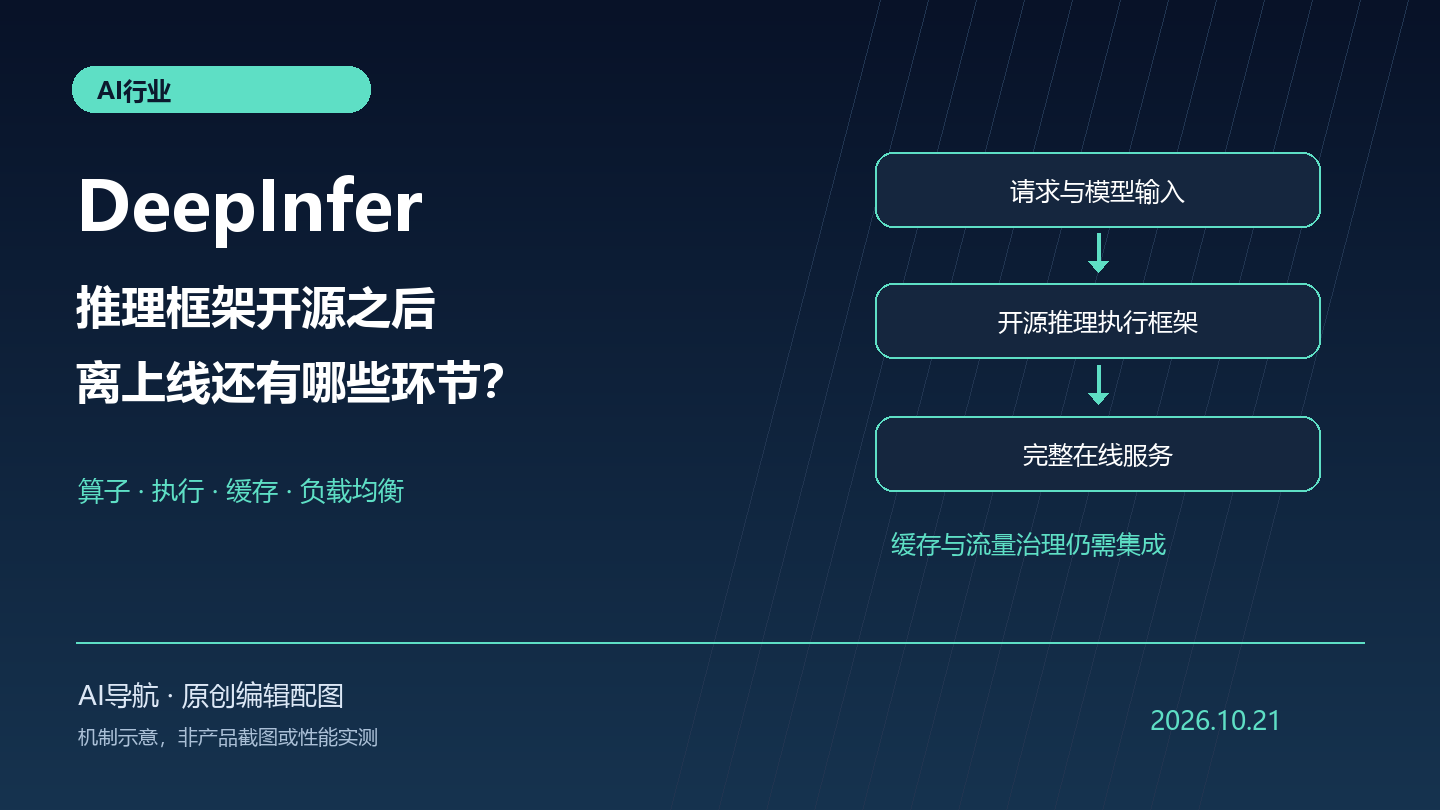
DeepInfer的README明确列出完整推理服务仍需要的部分:KV缓存系统、视觉编码与预填充及解码的分离部署,以及预填充和解码阶段跨数据并行副本的负载均衡。部署问答进一步解释,缓存管理与负载均衡紧密依赖DeepSeek内部基础设施,相关代码尚未完全开放。
这一区分直接影响团队预算。模型能在服务器上生成文字,只能说明推理链路已跑通;当请求突然增加、长短任务混在一起或节点故障时,仍要处理排队、缓存容量、流量分配和可观测性。把一个离线样例包装成生产API,工作量通常集中在这些外围系统。此处是基于组件边界的工程判断,并非DeepInfer已出现故障的结论。
从部署问答看行业变化:更重视整条服务链
官方问答把多厂商加速器支持、预填充与解码分别组织、长时间上下文复用列为系统设计目标。这说明推理优化不只是某个算子“快一点”:输入处理、生成阶段、通信和缓存相互制约。尤其在反复读取同一份长文档的业务里,复用已有上下文计算可能比单次生成速度更影响实际成本。
不过,问答描述的是完整内部系统的目标与实践,不能把其中的缓存能力直接归到本次已开源代码。企业采购或技术评审时,应把“仓库已提供”“文档阐述但需自行实现”和“尚待测量”的内容分开列清。
如何读性能图:先核对硬件,再谈性价比
README给出的性能图分别在4张SM100 GPU上测预填充、64张上测解码,并注明位于单一scale-up域。不同芯片、互联、输入输出长度和批量配置都会改变结果。因此,图表更适合当作复现实验的起点,不能据此推断普通单机也能获得相同比例的提速。
评测指南将生成与判分分开,并强调只有任务覆盖完整时,Pass@1结果才有效。框架吞吐和模型答题正确率也是两类指标:前者反映资源利用与延迟,后者用于检查部署后模型行为是否正常。评估替换方案时,建议用自己的请求分布同时记录首字延迟、逐字生成延迟、失败率及每个完成任务的资源消耗。
与vLLM、SGLang的关系及生态影响
DeepInfer在致谢中写明,其早期主要建立在vLLM之上,并借鉴SGLang及TensorRT-LLM。vLLM官方文档同样把连续批处理、前缀缓存和分布式推理列为服务能力。这些资料共同说明,推理基础设施并非互不相干的孤立产品,优化方法和组件会在开源项目之间流动。
我们的判断是,模型厂商公开自己的推理实现,会让企业更容易检查模型与运行框架之间的适配细节,也会增加框架维护、硬件验证和系统集成的选择成本。现有业务是否迁移,仍应由可复现结果决定,而不是仅凭“官方框架”的身份。
适合哪些人关注
正在部署DeepSeek模型的推理工程师、算力平台负责人、研究机构及国产加速器适配团队最值得跟进。已有成熟服务栈的团队可先做隔离环境对照实验;普通聊天用户则无需因为框架开源更换客户端。下一步值得观察的是支持模型和硬件是否扩展、在线服务外围组件如何补齐,以及社区能否复现不同负载下的收益。
来源参考
- DeepSeek官方仓库:DeepInfer说明、硬件与许可证
- DeepSeek官方部署问答:系统设计目标与未完全开源的组件
- DeepInfer官方评测指南:生成、判分与结果完整性
- vLLM官方文档:推理服务能力背景
资料核验:2026年10月21日。封面为AI导航原创机制示意图,不代表官方架构全图或实测结果。