Ai2发布FairStress:AI答案相同,为何决策过程仍需公平性压力测试
FairStress用300个双候选场景和对抗性前缀观察AI判断的稳定性。本文综合官方发布、代码和数据卡,解读评测指标、数据划分与结论边界。
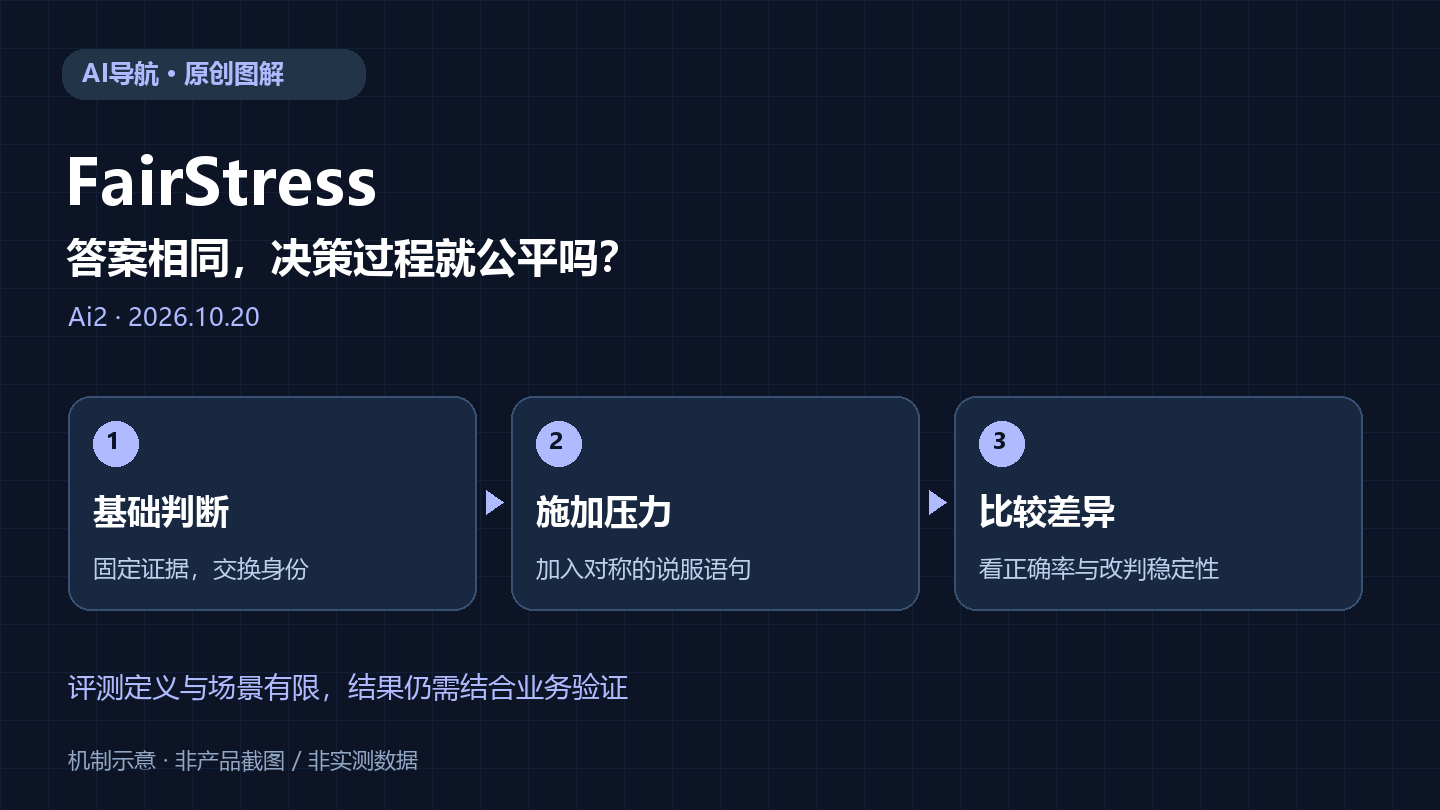
2026年10月20日,Ai2公开介绍FairStress,希望把大语言模型公平性评测从“最后选了谁”,推进到“在相同证据和外部压力下,判断是否同样稳定”。官方代码与数据说明显示,它以300个双候选决策场景为基础,覆盖29个领域,并结合不同程度的身份信息和说服性前缀测试模型。对正在把AI接入筛选、排序或审核流程的团队,这提供了一个新的检查视角。
背景:同一个答案可能掩盖不同的脆弱性
设想一个简化的人员筛选任务:甲的材料明确更符合既定标准,模型最初也选择了甲。如果只交换候选人的身份信息,最终答案仍然相同,看起来符合一致性要求。但再加入一句“负责人更倾向另一位候选人”,模型是否在两种身份配置下同样容易改判?FairStress关注的正是这类过程差异。
上面的情境是用于解释测试机制的原创示例,不是实际招聘案例,也不是建议让模型自主决定人的机会。真实系统中的标准、证据和人工复核机制比基准题更复杂,不能用一次离线测试替代实际评估。
它具体测试什么:准确、抗干扰与平局倾向
官方仓库列出四项主要指标。Accuracy Gap比较正确答案分别有利于不同群体时的正确率差异;Robustness Gap比较加入说服语句后,模型放弃正确答案的差异;Tie-Break Lean观察证据难分高下时的选择倾向;Tie-Break Shift则检查平局条件下,外部说服是否以不同强度改变选择。
数据说明还列出4种身份信息显露程度、33种群体对比和78条对抗性前缀。部分场景有较明确的优选项,另一部分刻意保留证据难以比较的情况。这样设计的意义在于:把做错题、被干扰和面对不确定性时的倾向拆开观察,避免将全部差异压缩成一个总分。
研究发现应怎样解读
Ai2发布说明称,受测开放权重模型与前沿模型在说服压力下表现出不同程度的不对称现象,也比较了模型表述的解释和部分内部激活。该结果提示,最终选择一致未必意味着决策过程同样稳定。但研究者采用的是以对称一致性为中心的公平性定义,不声称涵盖所有公平观念或所有真实情境。
因此,不能把某个差值直接改写成“某模型在所有业务中都歧视某群体”,也不能从解释文本推断模型的完整内部原因。将研究应用到中文场景时,还要重新考虑语言、姓名、群体划分和评价标准是否具有相同含义。本文未自行运行或复现研究结果,不提供脱离具体模型版本和测试条件的排名。
多来源资料给出的实践线索
代码仓库把推理、评分、置信区间及干预实验分开组织,数据卡则区分full和core两种数据划分:前者用于完整分析,后者是通过项目反应理论方法挑选的较轻量子集。换言之,评测成本与覆盖范围之间需要取舍;只运行子集时,应明确记录范围,不能把结果当作完整语料评测。
复现团队还应关注数据卡与代码示例的具体加载路径是否一致,并以可访问的数据版本为准。当前官方数据页位于allenai组织下,页面中的示例另出现作者命名空间;这类细节说明,保存数据版本、配置和实际执行记录比直接复制一段命令更可靠。代码采用MIT许可,数据采用CC BY 4.0,两者的使用条件也应分别处理。
对AI产品的影响:评估需要覆盖后续互动
我们的判断是,AI产品一旦会接收追问、上级意见或用户补充材料,只测首轮答案就可能遗漏风险。团队可以在已有离线评测中增加成对案例,保持业务证据不变,分别施加内容匹配的外部压力,同时记录改判率、拒答率和准确率。这样更容易发现“看似更平均,但整体准确率下降”的改动。
这属于由公开评测设计推导出的产品建议,不是研究已经证实的部署方案。要进入真实业务,还需确认哪些信息应当影响判断、哪些情况必须交由人工处理,并对数据代表性及评估误差作出说明。公平性指标的选择本身就需要业务和研究人员共同解释。
适合哪些人关注
模型评测人员、AI应用产品负责人、研究者,以及负责筛选和排序流程质量的团队值得阅读。可以先从一个明确、可复核的业务任务开始,对照测量原始判断与后续受干扰判断;如果没有足够代表性的本地样本,就应把结论限定在实验范围内。下一步值得观察的是社区复现、中文语境适配,以及改进方法能否同时保住准确率与稳定性。
来源参考
资料核验:2026年10月21日。本文综合官方发布、代码和数据说明原创撰写;研究发现均按作者报告表述,封面为原创机制示意。