Reflection开放Beam权重:501B模型如何接入可控Agent工作流
Reflection于10月16日开放Beam权重并配套部署与Agent集成。本文结合公告、模型卡与权重仓库,解释501B总参数和23B激活参数的区别,以及企业试用时的成本、中文评测和权限边界。
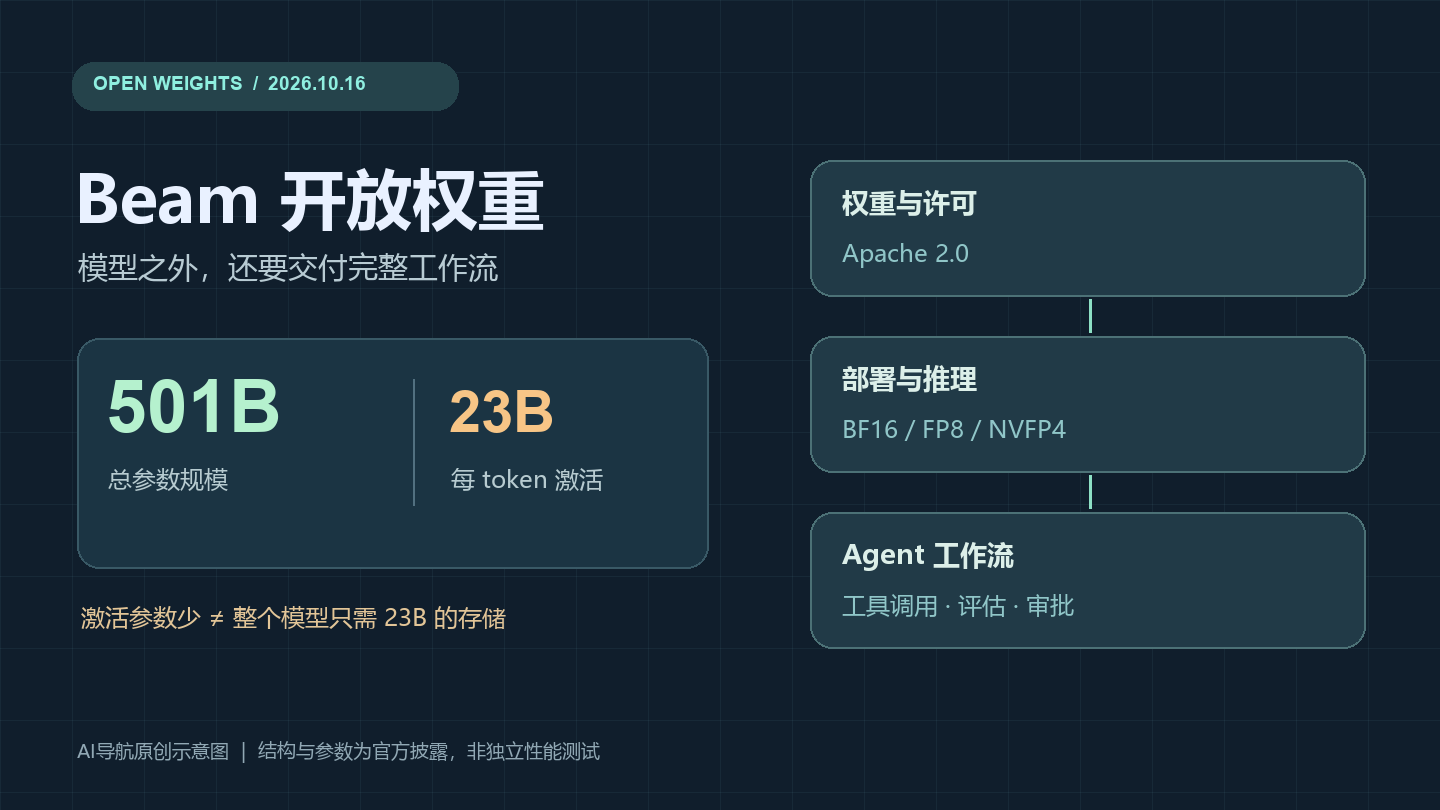
10月16日,Reflection宣布开放首款模型Beam的权重,并同步提供部署、定制与Agent集成路径。与10月5日的模型介绍相比,这次值得开发者关注的变化是:能否真正取得权重、按公开许可部署,以及把模型接进已有工作流。本文于10月18日核验公告、模型卡和Hugging Face仓库,讨论的是正式开放后的使用条件,而非把预告重写为一次全新模型发布。
发生了什么:权重、精度版本与接入路径一同到位
官方发布页称,Beam权重以Apache 2.0许可提供,并有BF16、FP8、NVFP4等数值精度版本。Hugging Face仓库的许可字段与说明相互印证。开发团队可以下载权重自托管,也可选择Reflection API或合作方的托管入口;具体地区、额度、计费和可用状态仍需到各平台单独确认,不能把“支持生态”理解为所有端点均向所有用户无条件开放。
模型卡进一步标明,Beam是文本输入、文本输出的稀疏混合专家模型,总参数约5013亿、每个token激活约234亿,标称上下文窗口为100万token。它侧重代码、推理与工具调用,不应被介绍为原生图像或视频模型。
背景:为什么234亿激活参数不等于一张小显卡就能跑
MoE通过为不同token选择部分专家计算,降低单次前向计算涉及的参数量,但未参与当前token计算的专家仍属于模型,需要存储、加载或跨设备调度。实际部署成本还受权重精度、KV缓存、上下文长度、并发量和通信方式影响。因此,“501B总参数、23B激活”可以说明计算结构,却不能直接推出硬件需求等同于一个23B稠密模型。
编辑部建议先用小规模、可重复的任务集确认效果,再选择托管推理或自建服务。尤其不宜只看最大上下文数字:长输入的延迟、成本和关键信息提取稳定性,应在自己的代码仓库或文档中验证。
影响:开放权重的价值开始取决于周边系统
Reflection把部署容器、推理适配、模型定制与Agent运行集成放在同一发布叙事中。我们的判断是,这体现了开放模型竞争的一项变化:拿到模型文件只是起点,把版本、工具权限、观测和回滚串起来,才可能形成可维护的业务能力。对已有私有化要求的团队,权重可控增加了选择空间;对小团队,自托管的运维与算力门槛并不会因许可开放自动消失。
模型卡中的基准分数属于发布方披露,且不同精度、测试设置和运行环境可能影响结果。它们不能替代独立复测,也不能直接保证中文业务、特定行业或真实生产任务的表现;README还说明模型开发主要面向英语,中文应用更应单独验收。
适合哪些人关注:开发者、企业平台与评测团队
- Agent和编程工具开发者:重点检查工具调用协议、现有运行框架兼容性以及失败后的恢复路径。
- 企业平台与合规团队:比较托管与自建的总成本,复核许可、数据出境、日志保留和敏感信息处理要求。
- 模型评测与安全研究者:保留版本和精度记录,在真实任务上报告成功率、人工干预次数、延迟及成本,而非只展示最好的一次结果。
试用前的底线:模型开放不等于权限开放
可以先让Agent只读一个脱敏仓库,允许执行白名单测试,把文件改写、联网、凭据访问和上线发布分别授权。需要人工确认的高风险动作不要仅依赖模型自觉拒绝。先验证行为边界,再逐步扩大权限,比直接接入生产账号更稳妥。
来源参考与核验说明
本文由AI导航编辑部综合以下公开一手资料独立撰写,事实与编辑分析分开表达;核验日期为2026年10月18日。不转载单篇报道,产品可用范围与研究结果以原始资料及后续更新为准。


