Recursive发布Flint本地编程模型:40B总参数之外还要看哪些部署条件
10月21日,Recursive发布Flint并开放权重。结合模型卡和rec仓库,梳理总参数与激活参数、量化版硬件要求、性能口径及编程代理的部署边界。
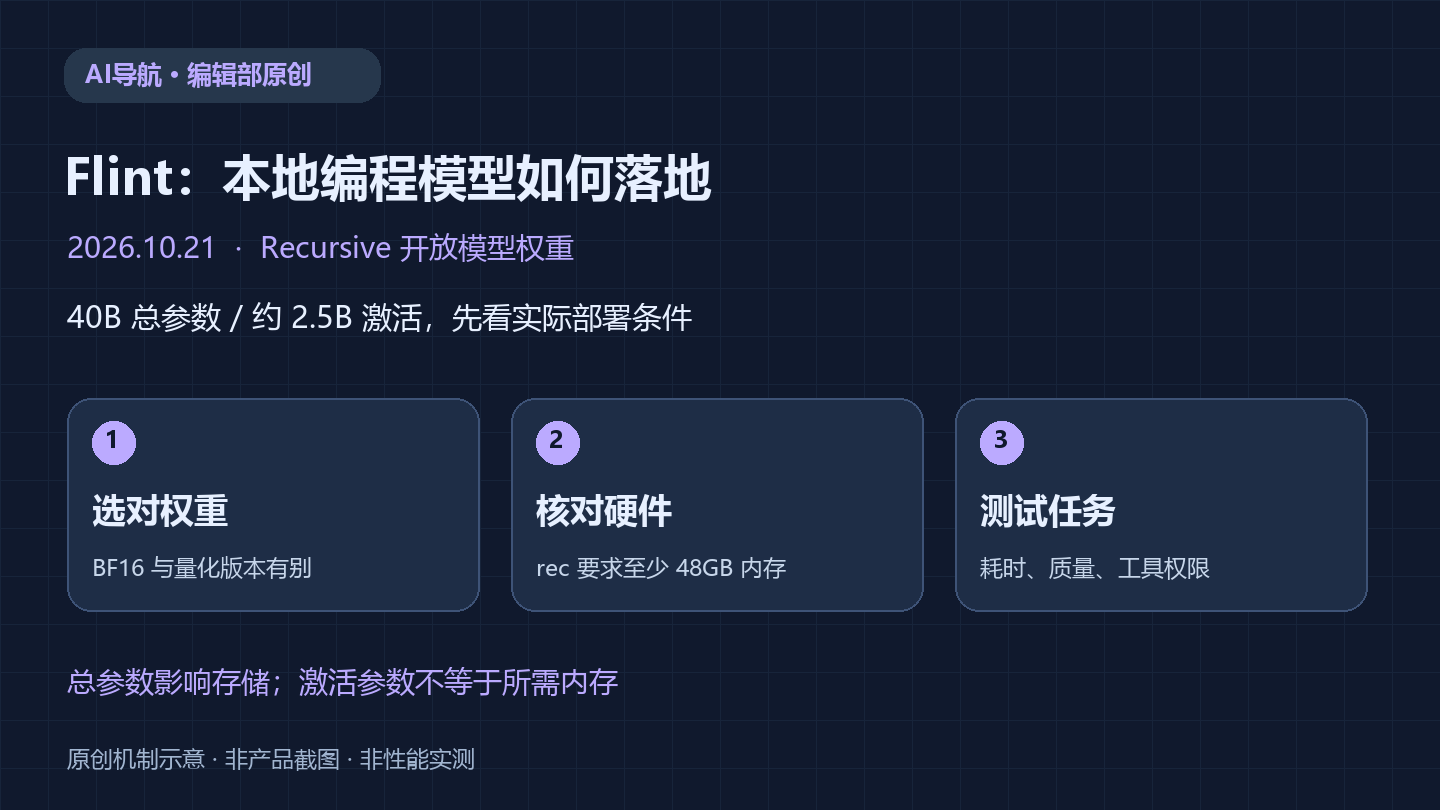
Recursive于2026年10月21日发布Flint,一款面向本地编程代理的混合专家模型,并开放模型权重。它把本地代码分析、修改与工具调用放在同一个产品方向中。理解这次发布,需要同时查看模型卡、量化方案与推理引擎要求;只看“激活参数较少”容易低估机器配置和集成工作。
背景:本地编程开始覆盖完整任务
代码补全主要处理局部片段,编程代理则会反复读取仓库、决定修改位置、运行检查并根据结果继续工作。这对持续的工具调用、上下文管理和错误恢复提出了要求。本地推理的吸引力,在于让部分模型计算留在用户自己的设备上,也让团队有机会控制模型版本和运行方式。
但一个真实任务的完成时间,还包含读取项目、处理输入、执行命令和测试等步骤。输出速度快,只能说明其中一部分。因此,评估本地编程产品时,应把单次生成速度与完整任务的可靠性分开记录。
模型卡给出了怎样的规格
Flint模型卡列出约398亿总参数、每个token约25亿激活参数,属于文本输入和输出的MoE模型,支持推理与多轮工具使用。官方用“40B-A2.5B”作为取整后的规模称呼。激活量描述单步计算参与的参数,总体权重依然需要占用存储和内存,两者不能互换。
模型卡记录的上下文配置为262144 token,包含输入与生成输出。这是容量配置,并非任意长度都保持相同准确率的保证。模型还提示,长推理可能消耗输出预算;部署者应针对目标任务核对具体权重精度、运行时与生成设置。
本地部署:量化版与BF16走不同路径
发布公告介绍了面向Apple Silicon和NVIDIA设备的推理优化。与之配套的rec仓库当前列出的要求,包括M4 Pro、M5 Pro或M5 Max芯片、至少48GB统一内存,以及约30GB可用磁盘空间,并明确针对单会话使用优化。这些条件应按当前仓库核对,不能扩展成所有笔记本都适用。
另一方面,模型卡提供的是BF16检查点,下载量约80GB,示例部署使用B300或H200 GPU和SGLang服务组件。笔记本量化路径与这套高精度服务路径具有不同的资源需求。读者应先确定自己下载哪个版本,再看对应的引擎说明。
性能与自动化研发应怎样解读
Recursive在发布资料中给出编程评测与推理速度结果,并称其Eureka Machine参与了数据、训练、量化及推理优化。本站没有复现相关实验,因此将其视为发布方报告;这也不能证明模型具备不受限制的自主研发能力。
模型卡同时提醒,各来源评测设置存在差异,工具环境和计分方式并不完全相同。编辑部建议用团队自己的仓库设置任务:选取能复现的问题,比较首次完成率、总耗时、测试是否通过,以及人工纠错次数。测速度时还应分别记录输入处理与输出生成,而不是把某个短上下文结果当作全天工作的平均效率。
适合哪些人关注,怎样开始验证
具备相应硬件的开发者、研究本地推理的工程师,以及需要控制代码处理环境的企业团队,可以把Flint纳入候选。优先用隔离的测试仓库验证读代码、修改和检查的完整链路,再决定是否接入日常项目。
权重采用Apache 2.0许可,但托管API条款和数据处理方式应另行核对。本地模型也可能生成错误代码或错误工具调用;若代理连接网络或外部工具,仍需逐项检查数据去向。模型在哪里运行、工具具有什么权限、产物是否通过验收,是三个需要分别回答的问题。
来源参考
编辑部于2026年10月23日核对以下公开一手资料。文中场景示例、评估建议与影响判断为编辑分析;性能信息未经本站复测。