NVIDIA与Oracle扩展Vera Rubin合作:AI代理算力为何不能只看GPU
NVIDIA与Oracle于10月27日宣布Vera Rubin NVL72及Vera CPU在OCI普遍可用,并披露多吉瓦扩建计划。本文区分已开放与未来规划,分析AI代理的CPU执行、GPU等待和完整任务成本。
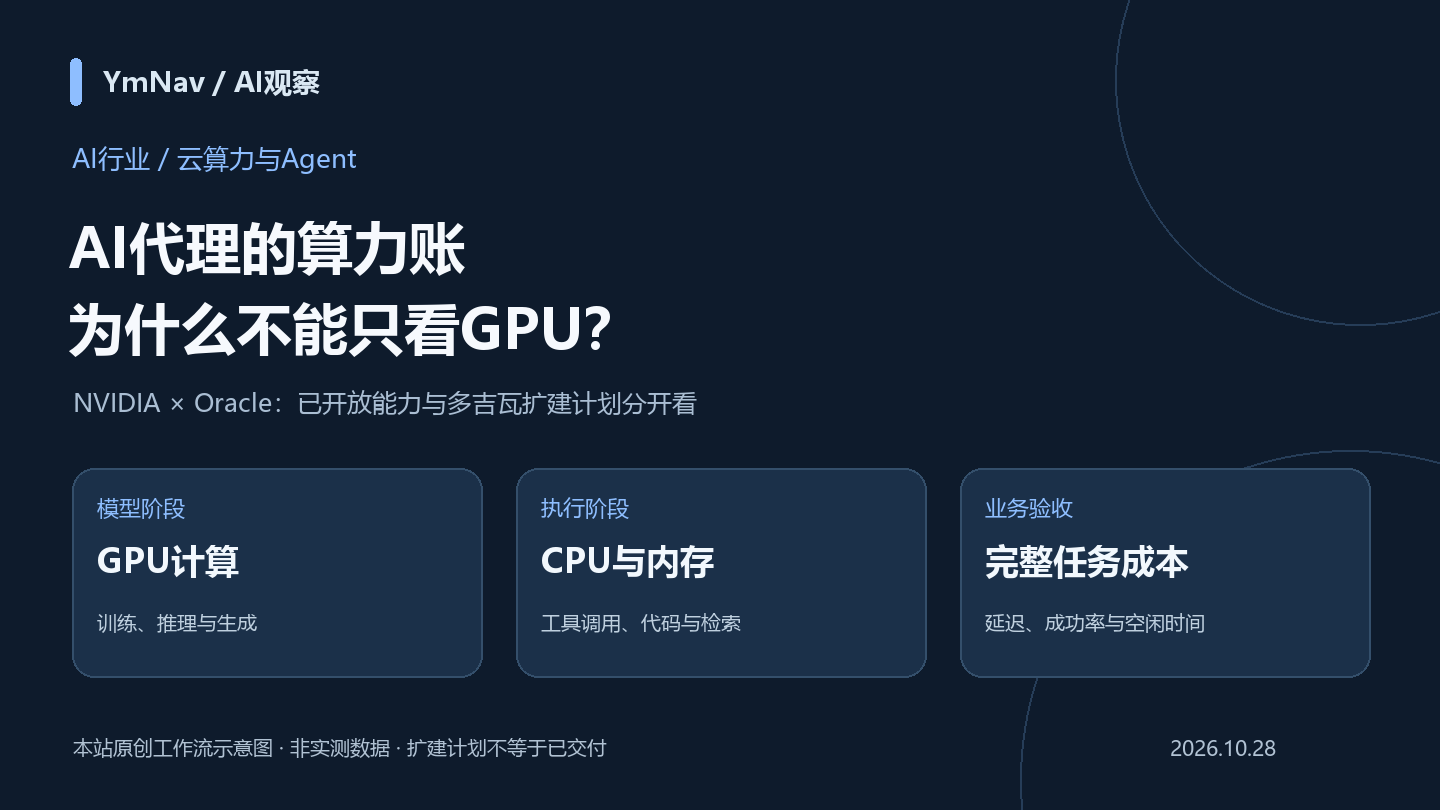
2026年10月27日,NVIDIA与Oracle公布新一轮AI基础设施合作:Vera Rubin NVL72与Vera CPU已在OCI宣布普遍可用,同时双方计划把相关超级集群扩展到多吉瓦规模。两类信息需要分开阅读,前者是服务开放声明,后者是后续扩建方向。对建设AI代理的企业,公告还提供了一个比GPU数量更贴近业务的问题:模型生成之后,那些工具调用和代码执行由谁完成?
背景:AI代理会在模型与工具之间反复切换
在客服问答之外,AI代理常常需要检索资料、运行程序、处理返回值,再决定下一次调用。GPU负责的模型计算只是完整任务的一环。NVIDIA的Vera CPU产品资料把工具调用、代码执行和评估循环列为针对的工作负载;Oracle的GPU计算介绍则展示了裸金属、虚拟机、集群网络等多种部署选择。
把这些资料放在一起看,企业的选择已经不只是租用哪款加速卡。CPU执行、内存供给、节点互联和调度方式都会参与决定任务何时结束,也会影响昂贵的计算资源有多少时间真正用于产出。
公告里的三个层次,分别意味着什么
第一层是已宣布开放的能力:双方称Vera Rubin NVL72与Vera CPU已在OCI普遍可用。具体地区、配额、交付时间及合同条件,仍应向服务方逐项确认。“普遍可用”并不自动等于任何客户在任何区域都能立即获得所需规模。
第二层是扩建计划:双方准备把采用Vera Rubin的OCI超级集群扩展到多吉瓦规模。吉瓦描述的是基础设施与供电容量尺度,不能直接换算成某个企业已经买到的GPU数量、已建成机房数量或实际可用推理吞吐。
第三层是拟引入的HGX Rubin NVL8配置。公告将其描述为基于x86服务器的八GPU选择,目前属于计划内容。它与已宣布开放的NVL72服务不能混写为同一交付状态;采购团队应分别确认可订购的规格和未来产品路线。
为什么此次合作同时强调CPU
公告指出,工具运行、代码测试与数据检索等CPU密集操作若完成缓慢,模型调用之间就可能出现等待。Vera的官方架构资料强调单线程性能、内存带宽与数据移动能力,正是针对这些执行环节。双方还介绍了通过OCI Kubernetes Engine独立扩展CPU与GPU资源的方式。
本站据此判断,AI代理的基础设施优化应先找到等待发生在哪里。若一个任务的大部分时间花在外部数据库或第三方接口上,更换GPU未必能显著缩短总时间;若同时启动大量执行环境,则CPU、内存与隔离开销可能更值得先测。这里讨论的是诊断思路,并非对该产品的性能结论。
影响:从每小时算力价格转向完整任务成本
对企业用户,更实用的比较单位可以是“完成一个通过审核的业务任务需要多少成本”。建议在同一任务集上记录模型等待、工具执行、数据读取、失败重试、人工复核和资源空闲时间,再同时查看成功率与尾部延迟。只比较单次生成速度,可能漏掉代理工作流里真正昂贵的环节。
例如,在代码修复试点中,团队可以固定一组问题,把生成补丁、运行测试、处理失败和人工确认都纳入计时。若新配置只让生成更快,却没有减少测试等待或返工,总体收益就需要重新计算。这个验收例子由本站提出,不对应厂商已发布的用户测试结果。
部署边界:容量、安全与兼容性要分别确认
Oracle资料列出的不同计算形态和地域部署方式,为团队提供了选择范围,却不能代替具体工作负载的兼容测试。现有镜像、依赖库、执行沙箱与网络访问策略,仍需要按目标CPU和集群配置验证。公告关于隔离和性能的产品表述,也不等于应用侧已经完成权限设计。
同时,双方公告包含未来产品与前瞻性说明。本文不把扩建方向写成已完工事实,也不依据未经本站复核的厂商宣传推算固定降本比例。上线决策应围绕实际可交付配置、服务约定和自己的任务结果作出。
适合哪些人关注
企业Agent平台工程师、云架构师和推理服务团队,可关注CPU与GPU的资源配比;采购负责人可据此拆分服务开放、容量预约和未来路线三类事项;行业观察者则可以跟踪大型AI基础设施如何从模型训练扩展到代理执行。
来源参考
本文根据多份官方公开资料独立整理与分析,资料核验日期为2026年10月28日。产品开放范围与部署进度以官方后续说明为准。