Fish Audio Drama 3发布:AI配音走向可导演,编辑功能仍在邀请测试
Fish Audio于10月13日发布Drama 3,技术报告于14日更新。新模型强调用自然语言控制语气与表演,已提供网页、应用及API入口。本文结合公告、模型卡和技术报告,区分可用功能、邀请测试与开放权重的商业边界。
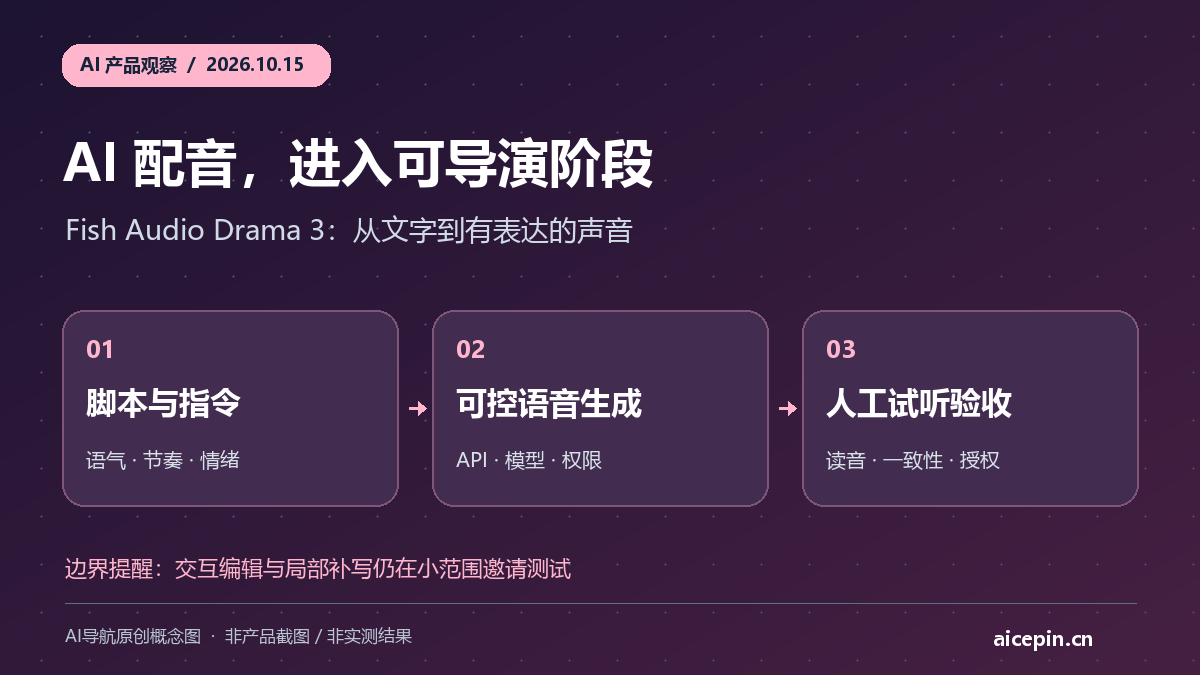
从“读出文字”到“听懂导演要求”,AI配音的产品重点正在变化。Fish Audio在10月13日公布Drama 3,相关技术报告于10月14日更新。对中文创作者而言,值得关注的不是又一个“最自然”的宣传口号,而是语气控制、反复试音和交付边界能否进入日常工作流。[1][2]
发生了什么:用语言描述表演,而不只选择音色
官方公告称,Drama 3已经提供Fish Audio网页、移动应用和API入口,用户可以在文本中加入自然语言表演指令,对语气与情绪变化提出要求。这属于项目方介绍的能力,不意味着所有文本、语言或角色都能一次生成满意结果。[1]
技术报告介绍了一个总参数约350亿、每个token激活约30亿参数的混合专家骨干,并讨论语音生成、指令跟随及推理设计。[2] 需要注意,“激活约30亿”不等于整个模型只占用30亿参数对应的存储,也不能据此宣称普通电脑必然可以流畅运行。模型权重、运行框架和硬件条件需要分别核对。[3][4]
背景:配音生产的难点常在“这一句不对”
在有声书、游戏对白或短视频旁白中,读音清楚只是起点。人物是否压低声音、情绪在哪个词转折、前后句是否一致,都会影响最终听感。编辑部认为,可控生成的价值,是让创作者更明确地表达这些要求,而不是把所有选择交给随机采样。
也因此,评估不能只听官方精选样片。更有意义的是用自己获得授权的脚本,连续测试专有名词、数字、中文多音字和长段落,再观察不同版本能否保持一致。这里列出的项目是评估维度,不是本文已经完成的实测。
功能边界:可用的TTS,不等于编辑工具全面上线
必须把模型研究能力与公开产品入口分开。官方公告明确表示,多轮交互编辑和局部音频补写处于小范围邀请测试,编辑API仍在后续计划中;普通用户不能因此假定自己已经可以任意替换成品音频中的某个词。[1]
技术报告和模型卡有助于理解模型能够处理哪些任务,公开服务文档则说明目前如何调用。两者不在同一层面:研究中展示一项能力,并不自动意味着它已成为稳定、普遍开放的生产功能。[2][3][4]
开放权重的边界:下载得到,不代表使用方式不受限制
模型采用Fish Audio Community License v1.0,而不是没有商业条件的通用许可。按当前许可证文本,部分商业用途要求使用者及关联方合计年收入低于50万美元;向第三方提供符合定义的托管语音生成服务,则涉及单独书面授权要求。门槛、用途例外和服务定义应阅读完整原文,不能只看“免费商用”四个字。[5]
许可证同时对未经同意克隆真人声音作出限制。对内容团队而言,模型使用许可与声音、脚本、角色的授权并不是同一件事。本文只是对公开条款的事实提示,不替代具体项目的许可核查,也不把开放权重宣传成可随意仿冒他人声音。
影响:竞争焦点可能是可验收的声音工作流
编辑部判断:如果控制与修改能力能持续改善,AI配音可能更接近“脚本—试音—反馈—再生成—人工验收”的生产链,而不是一次性把整篇文字转成声音。但目前没有足够依据把产品演示外推为固定的效率提升比例,更不能宣布配音人员已被完全替代。
真实成本还包括筛选失败样本、检查读音、维持人物一致性、保存授权记录及后期混音。项目方的硬件性能结果有明确实验条件,不应直接当成所有开发者部署后的延迟保证。
适合哪些人关注:创作者、游戏团队与语音开发者
- 有声书和播客团队:适合观察章节间音色、节奏及情绪一致性,优先测试已获授权的素材。
- 游戏及动画制作方:适合研究角色对白的表演控制,不宜把邀请测试功能写进确定交付承诺。
- 语音应用开发者:关注API、运行资源和许可定义是否匹配自身业务,而不只比较样片效果。
来源参考与信息边界
本文结合官方公告、技术报告、模型卡、服务文档及完整许可证独立撰写。事件发布日为10月13日,技术报告更新日为10月14日,本文核验日为10月15日;未将早先发布误写成今天首发,亦未采信缺乏可比条件的综合排名。


