Mistral发布Timestral:时序预测走向小模型,开放权重仍有商用边界
Mistral于10月15日发布Timestral时序基础模型,提供5M至209M四档规模,支持多变量概率预测及协变量。本文解析CPU部署、企业评估方法,并提醒Modified MIT并非无条件商用许可。
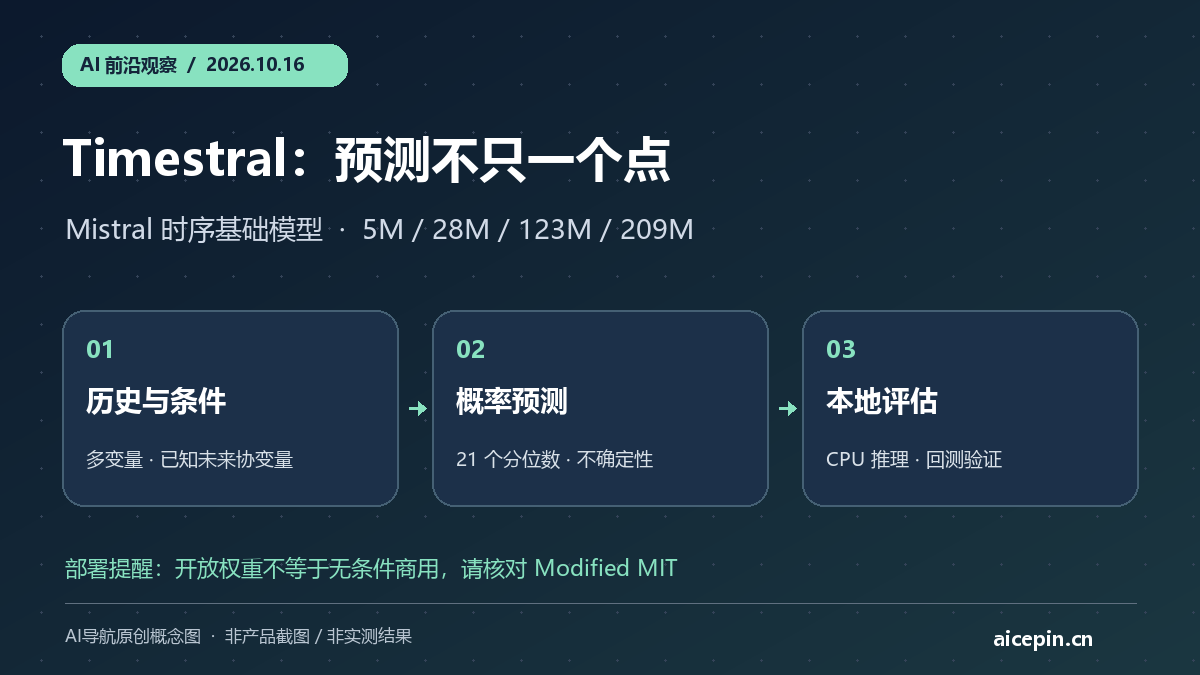
聊天模型生成文字,预测模型则要回答另一个问题:下一小时设备负荷会怎样,下周需求可能落在哪个区间?10月15日,Mistral发布Timestral,将基础模型路线进一步带入企业时序数据。它不是聊天助手的新名字,而是一组围绕历史序列、外部条件和未来不确定性设计的预测模型。
这次发布了什么:四档模型,不只输出一个预测点
官方公告与模型仓库列出5M、28M、123M、209M四种参数规模。Timestral面向多变量概率预测,支持历史协变量与已知未来协变量,输出21个分位数;官方给出的上下文长度为32768个时间步。这里的时间步不是语言模型的文字Token,也不能直接换算成固定天数,要看数据采样频率。
一个实际区别是,预测目标以外的信息也能参与建模。例如排班表属于可能提前确定的未来条件,传感器历史则属于已发生的信息。评估时必须区分“决策当时已知”与“事后才知道”:把事后真实天气当成当时已有的天气预报,可能制造虚假的好成绩。
背景与影响:企业AI不必都围绕更大的聊天模型
Mistral在公告中将Timestral与传统单序列方法、需针对具体数据集训练的深度学习方法进行区分:时序基础模型希望借助预训练,先对未见过的数据进行零样本预测,再视业务需要适配。代码仓库提供本地使用入口;官方也介绍了通过Forge进一步适配的路线,但不能把“能够适配”理解成企业无需数据治理。
官方强调CPU推理,并展示若干公开基准结果。这些属于厂商披露,本站没有独立复现,也不据此承诺在所有行业领先或在任意CPU上达到固定延迟。更值得关注的变化是,团队可以围绕数据规模、推理成本与误差容忍度选择模型,而不是先采购最大规模算力再寻找用途。
开放权重的边界:请读完整许可证
模型卡标注为Modified MIT。209M模型原始LICENSE还包含一项重要条件:如果公司或雇主上一月全球合并月营收超过2000万美元,则不被授权依据这份许可行使相关权利,条款还覆盖衍生、修改或组合成果;文件给出联系Mistral申请商业许可等路径。因此,“可下载权重”不应被写成“任何企业均可无条件商用”。本段为条款提示,不替代具体项目的授权审查。
适合哪些人关注:先做可复现的小规模回测
供应链与需求规划团队、设备运维团队、能源数据团队,以及负责预测服务的数据工程师值得关注。以下是编辑部建议的评估顺序,并非产品效果保证:
- 先设基线:保留季节性简单预测和现有生产模型,按同一时间切分比较。
- 防止数据穿越:滚动回测只使用当时可得的信息,单独记录协变量来源与更新时间。
- 评估区间而非只看均值:检查预测区间覆盖、异常时段误差和不同业务分组,避免总分掩盖关键场景失效。
- 核算端到端成本:把数据清洗、批处理、硬件、重训与授权审查一起纳入成本,而非只看参数量。
我们的判断是,Timestral的新闻价值不是“通用AI又能预测了”,而是时序基础模型开始提供更细的部署与成本选择。是否适合生产,仍应由自己的回测、权限要求和服务指标决定。
来源参考与核验说明
本文为AI导航编辑部结合公告、代码仓库、产品文档与原始条款独立整理;未实测产品,厂商自报结果不等同于独立评测。资料核验日期:2026年10月16日。


